

日本 AI 公司 higurashi 在 11 月 12 日开源了语音对话模型 Haru-4B,底子是阿里的 Qwen3.5。它和平时用的语音助手最大的不同是听和说同时进行:你还在讲,它可以"嗯""对"地插话。你打断它,它会停下来听。代码和模型权重都是 Apache-2.0 许可证,可以商用,一张约 12GB 显存的英伟达显卡或者一台 Apple 芯片的 Mac 就能在本地跑。
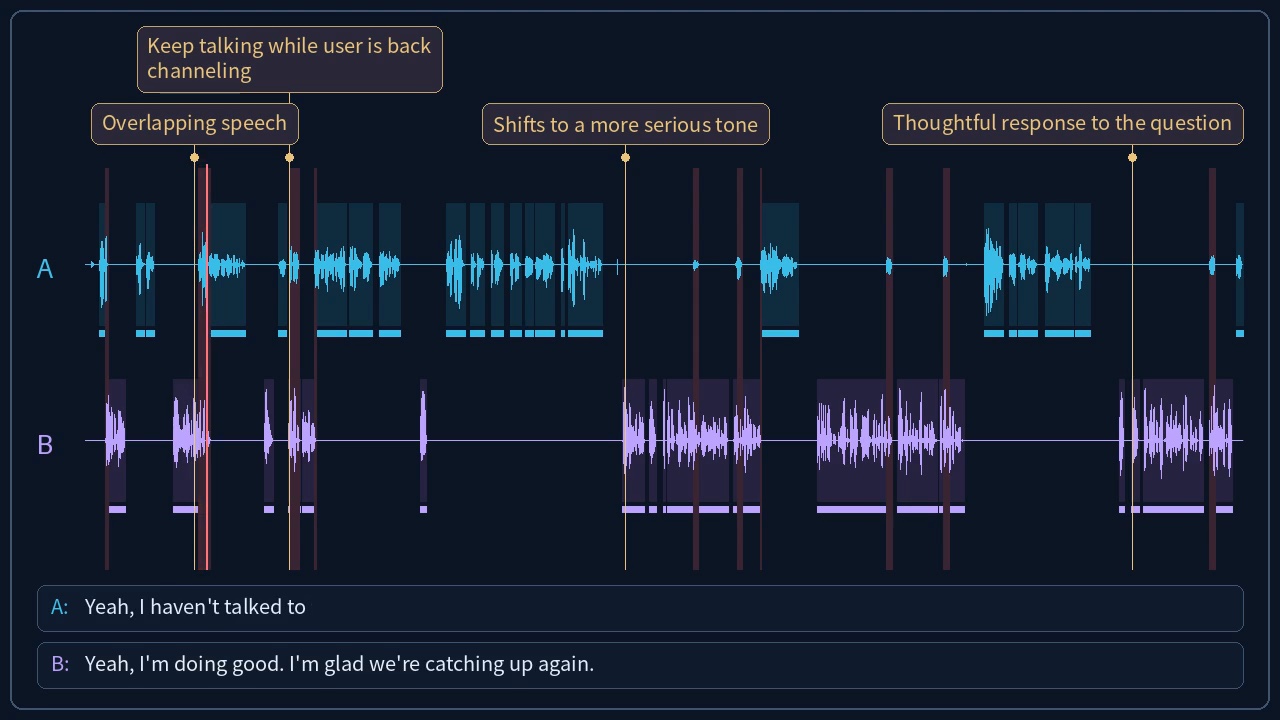
图片来自 higurashi 官方技术博客的演示视频,上下两条声轨分别是对话的两个人。
发生了什么
常见的语音助手是"对讲机"式的:等你说完、停顿一下,它才开始想、开始说,中间插不上话。Haru-4B 走的是"打电话"式的路线,业内叫全双工:
| 一问一答的语音助手 | Haru-4B | |
|---|---|---|
| 什么时候开口 | 等你说完、检测到停顿 | 随时,边听边决定 |
| 你插话 | 多数要等它说完,或者按键打断 | 直接说,它会让着你 |
| 应声和重叠 | 基本没有 | 会"嗯""对",两人同时说话也能接住 |
| 换语气 | 按文字回答再念出来 | 跟着对话气氛变 |
它每 133 毫秒处理一小段声音:收进你的一小段话,同时吐出自己的一小段话和对应文字,所以听和说互不等待。训练用了超过 4000 万小时的真实语音,官方说刻意没有用 AI 合成的一问一答对话,好让它学会真人说话时的停顿、抢话和应声。
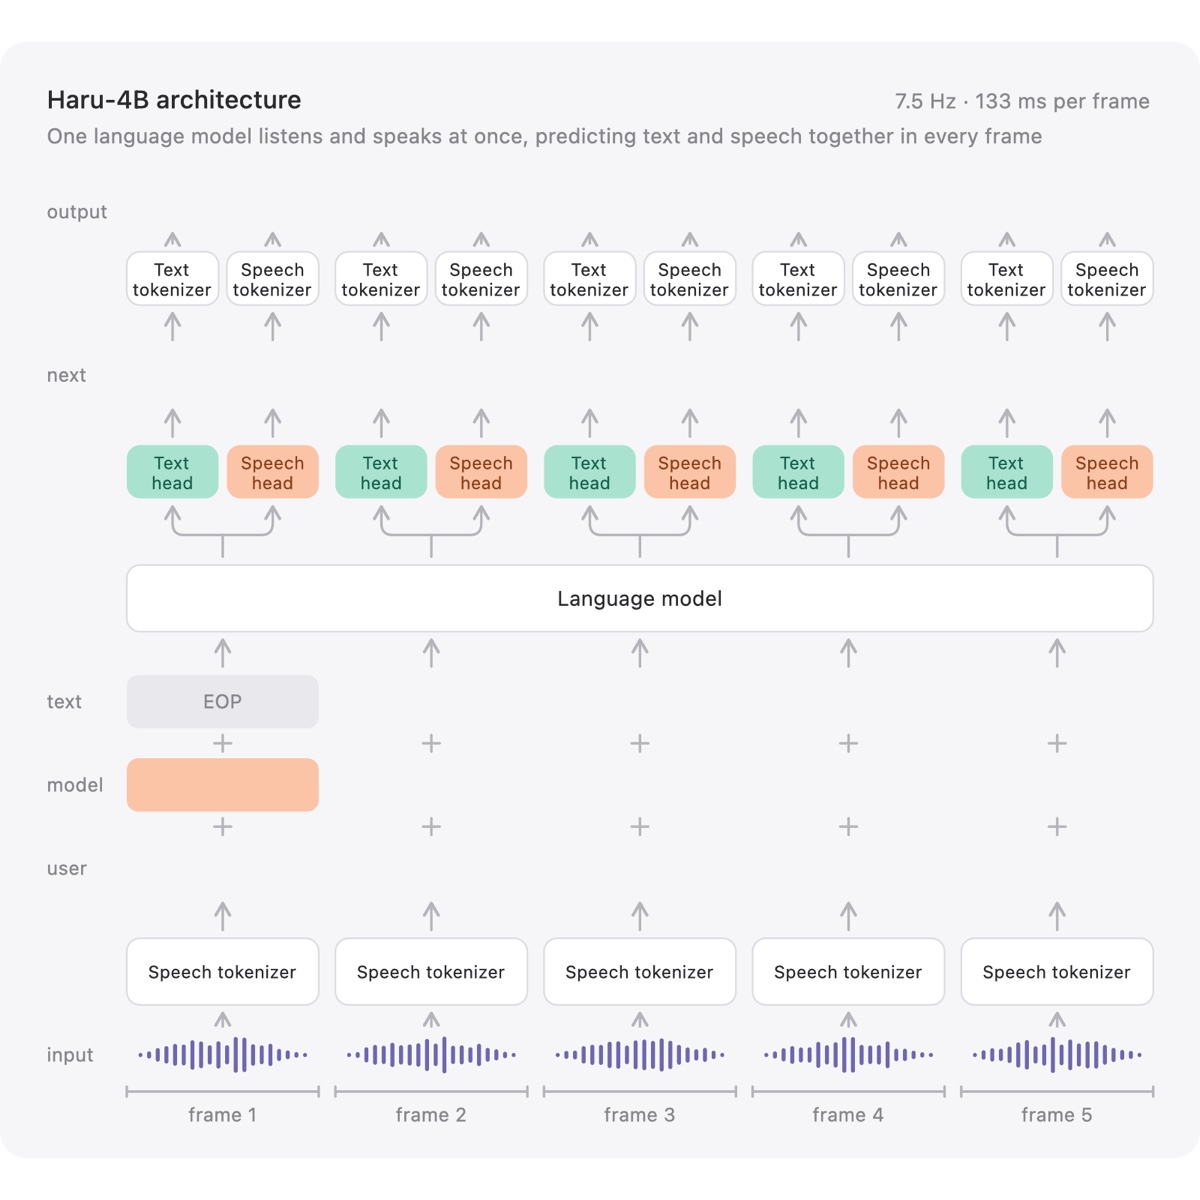
图片来自项目 GitHub 仓库。
能在什么电脑上跑
- 英伟达显卡:显存约 12GB,官方给了网页版演示,浏览器打开就能对着麦克风说话。
- Apple 芯片的 Mac:官方有原生 macOS 应用,模型约 10GB,内存 16GB 起步才实用。官方在 M1 Max 的 MacBook 上测到约 65 毫秒的处理延迟(从麦克风进、到耳机出,用的是 int8 量化),切分声音还会额外多出最多 133 毫秒。
- 服务器:支持用 vLLM-Omni 部署,同时服务很多路对话。
支持九种语言,中文、英语、日语和韩语都在内,另外还有西班牙语、葡萄牙语、德语、法语和俄语。
想试的话,可以把下面这段交给你的 AI Agent:
帮我在本机试用开源语音模型 Haru-4B,仓库:https://github.com/higurashi-ai/Haru
1. 先读仓库 README,告诉我我的电脑能不能跑(英伟达显卡约 12GB 显存,或者 Apple 芯片 Mac 加 16GB 内存),要下载多大的模型。
2. 要装软件、下载模型之前先问我。
3. 装好后启动演示,告诉我打开哪个地址。它需要一段 3 秒到 3 分钟、只有一个人说话的干净录音当声音,我会用自己的声音。
4. 不要加 --share 参数,不要把演示开放到公网。
注意
- 它不是现成的助手:官方说得很清楚,Haru-4B 是给研究用的预训练底模,聊得自然,但事实不可靠,也不会像助手那样听指令办事。想拿它做产品,还要自己再训练。
- 会模仿声音:它照着你给的参考录音说话,只能用你有权使用的声音,别拿别人的录音。
- 蓝牙耳机会拖慢:官方建议用有线耳机和有线麦克风,蓝牙会再多出 100 毫秒以上。
- 分享链接走第三方服务器:演示加
--share会生成一个公开链接,谁拿到都能用,声音也会经过 Gradio 的服务器。 - 模型只有 40 亿参数,官方自己也说回答质量受限于此,正在训练 1000 亿参数以上的更大版本。
评论(0)
还没有评论,来说第一句。