

蚂蚁集团旗下的 inclusionAI 开源了语音大模型 Ming-3.0-audio-flash,MIT 许可,可以免费商用。它直接"听"音频而不是先转成文字再处理,能做语音识别、听完回答问题、分析一段录音里发生了什么,还能用内置音色或你给的参考声音把回答念出来。在 Artificial Analysis 的语音推理榜上,它以 99.8% 排第一,领先 Grok Voice 3.0、Gemini 3.8 和 GPT-Realtime-2.1。
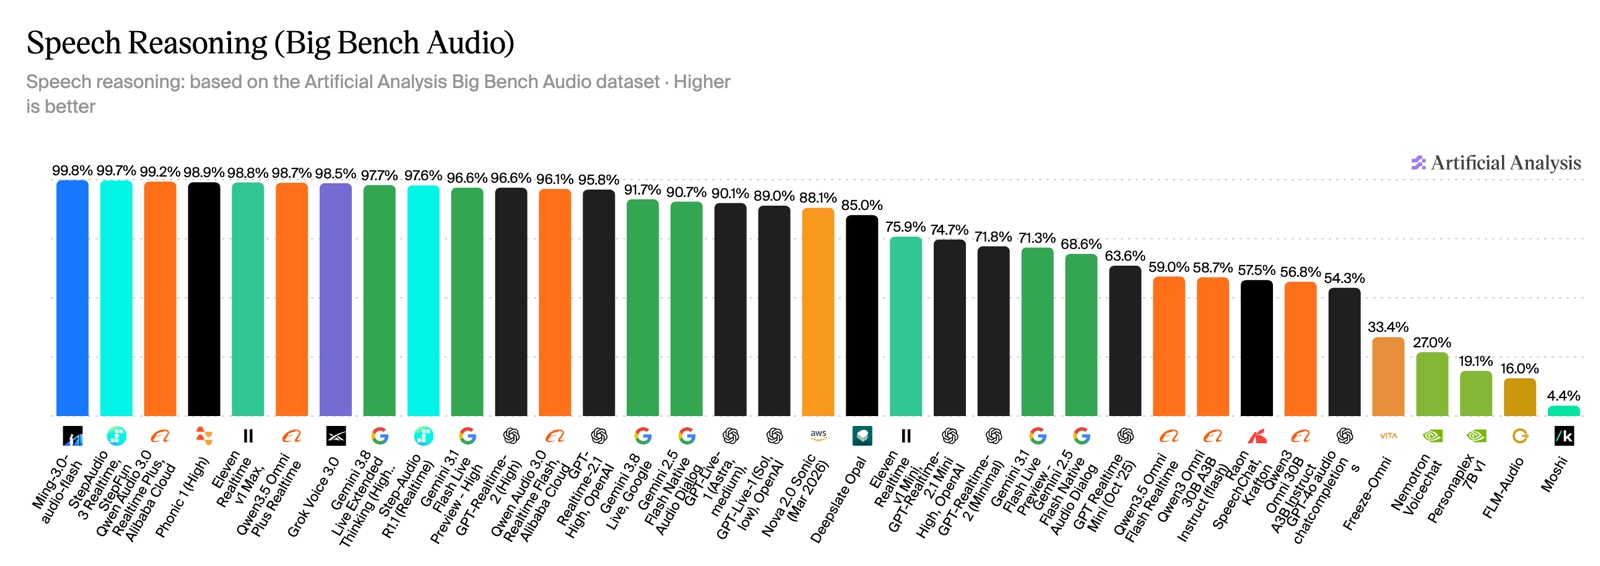
图片来自模型的 Hugging Face 主页。这个榜测的是"听一段语音提出的问题,再推理出答案"的能力。
这个第一要怎么看
榜首确实是它,但前几名挤得很紧:阶跃星辰的 StepAudio 3 Realtime 是 99.7%,阿里的 Qwen Audio 3.0 Realtime Plus 是 99.2%,前七名都在 98.5% 以上。也就是说,在"听懂语音并推理"这件事上,头部模型已经接近满分,差距只有零点几个百分点。真正有意思的是:一个能下载、能自己部署、还能商用的开源模型,站到了这一档。
模型主页还放了语音识别、音频理解和文本能力的成绩表,其中标星号的是团队自己测的,参考时要留意。
两个版本
| Ming-3.0-audio-flash | Ming-3.0-audio-tiny | |
|---|---|---|
| 总参数 | 1260 亿 | 93 亿 |
| 每次实际用到 | 65 亿 | 27 亿 |
| 官方给的部署参考 | 4 块 80 GB 的 H800(128K 上下文),长音频可能要 8 块;SGLang-Omni 方案用 2 块 | 文字输出或语音识别 1 块显卡,带语音回答 2 块 |
| 许可 | MIT | MIT |
两个都是"混合专家"结构:参数总量大,但每次推理只调用其中一小部分,所以比同规模的普通模型跑得快。不过 Flash 版要把全部参数装进显存,普通电脑跑不动,个人想试更现实的是 Tiny 版或租云显卡。
能做什么
- 复杂语音识别:中文、英文、方言、口音、嘈杂环境、多人说话都能转写。
- 长音频理解:整段会议、播客录音可以直接问"讲了哪几件事"。
- 不只听人声:环境声、音乐、声音场景也能分辨。
- 语音回答:可以只回文字,也可以用内置音色念出来,或者给一段参考录音模仿它的声音。
部署后提供和 OpenAI 格式兼容的接口(转写、语音合成、对话),已经接入 OpenAI 格式的工具和 AI Agent 改个地址就能连上。
让 AI Agent 帮你判断要不要试
蚂蚁开源了语音模型 Ming-3.0-audio-flash(Hugging Face:inclusionAI/Ming-3.0-audio-flash,还有小一号的 inclusionAI/Ming-3.0-audio-tiny),MIT 许可。请帮我判断值不值得用:

1. 我想用它做:[比如 把会议录音转成文字再出纪要 / 给我的 App 加语音问答 / 方言录音转写]。
2. 只读检查我这台电脑的显卡和显存,对照两个模型主页写的部署要求,告诉我能跑哪个、跑不了的话租什么规格的云显卡合适,大概怎么计费。
3. 和我现在用的方案对比:[比如 Whisper / 某个云端语音 API],列出各自的优缺点。
4. 它的加载代码需要 trust_remote_code,先读一遍仓库里的代码,告诉我有没有可疑的地方。
5. 不要下载模型、不要安装任何东西、不要开通付费服务,先给我结论,等我确认。
注意
- 显存门槛高:Flash 版官方参考配置是 4 块 80 GB 显卡,Tiny 版也至少要一块显卡。
- 要运行仓库自带代码:加载时需要开启
trust_remote_code,官方也提醒先审查代码再开。 - 声音克隆别乱用:用参考录音模仿别人的声音前,先取得本人同意,也别拿去冒充他人。
- 榜单只是一面:语音推理分数很高,不代表你的场景(比如某种方言、专业术语)一定好用,拿自己的录音试过再定。
评论(0)
还没有评论,来说第一句。