

用 MiniMax H3 生成视频,人站得远一点,脸就容易糊成一团。开源的 ComfyUI 插件 ComfyUI-H3-FaceRefine 专门修这个:把那张小脸单独拎出来放大,让 H3 重画一遍,再贴回原片。 它是 MIT 许可,GitHub 上 600 多星,最新版本是 1.1.2。
为什么远景的脸会崩
插件作者说得很清楚:H3 把脸画坏,看的是脸在画面里占多大,跟输出分辨率无关,所以就算出 720p 甚至更高,远处那张只有几十像素高的脸照样崩。把视频放大到 2K 也救不回来,放大的是已经画坏的脸。
它是怎么修的
整个过程分四步,都在 ComfyUI 里自动跑:
- 找脸、跟住:每一帧都检测人脸,盯住同一个人,框子跟着人动,不来回跳。
- 裁成方图:把脸那一块裁下来放大,让脸占满一张 768×768 左右的画布。
- 让 H3 重画:用较低的重画强度把这段方图重新生成一遍。脸越小重画得越多,本来就清楚的大脸只轻轻修。
- 只贴回脸:把重画好的脸贴回原视频,脸以外的画面保持原样。
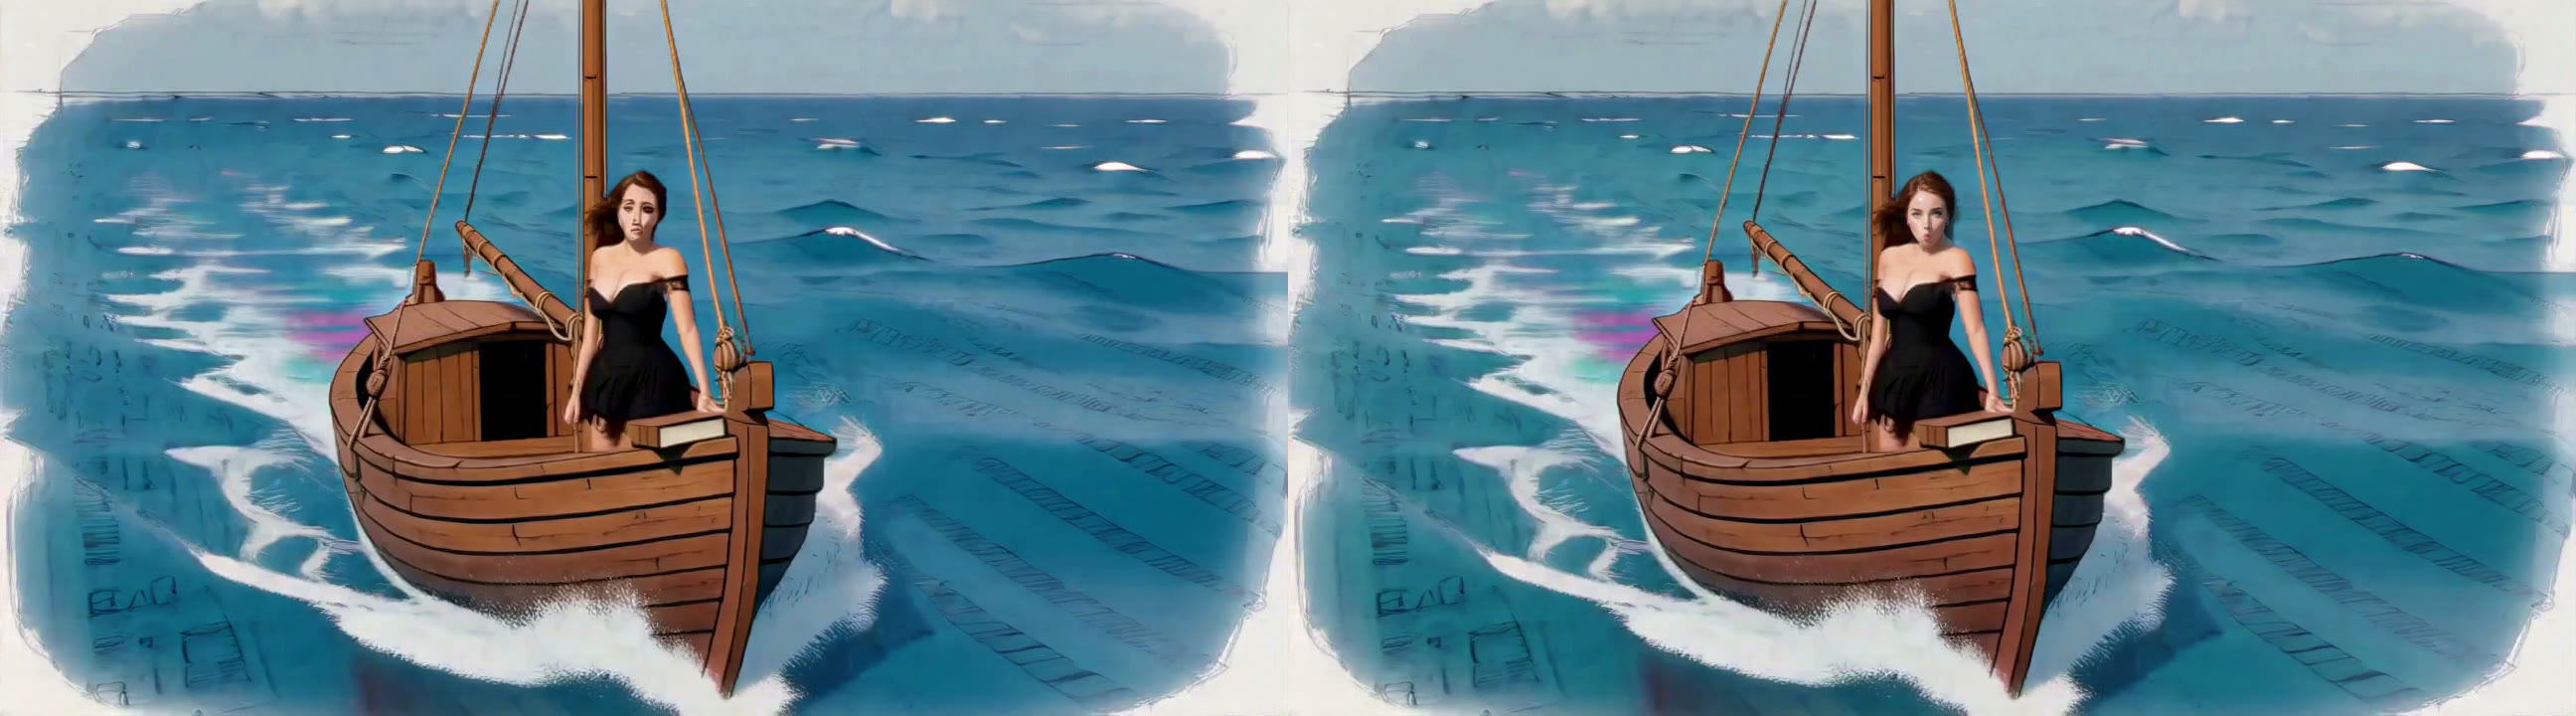
图片来自项目 GitHub 仓库的对比示例。左边是原片,右边是修过的。
思路借鉴了 ComfyUI 里给图片修脸的老牌节点 FaceDetailer,只是从单张图改成了整段视频。有用户在 RTX 4080 上实测,重画强度 0.6,一段 6.6 秒的片子大约两分钟修完。
还能做什么
- 画面里人多时只修一个人:可以给一张这个人的参考照片,它按长相认人,挤在人群里也跟得住。也可以在界面里一个镜头一个镜头手动点选。
- 带切镜的视频也能处理:打开切镜检测后,它会按镜头分段,每段重新挑人。还可以设成自动跳过这个人没出现的镜头,省掉白跑的时间。
- 对口型:H3 本身是音画一起生成的,接上作者推荐的音频节点后,重画时嘴型还会跟着人声走。
- 动漫角色:默认的人脸检测是给真人用的,动漫要换成动漫人脸检测模型,认人也换成专门的模型。
要准备什么
| 需要 | 说明 |
|---|---|
| ComfyUI | 版本要新到自带 MiniMax H3 节点(H3 现在是 ComfyUI 内置的) |
| H3 模型 | 本来就在用 H3 出视频的话,这些都已经有了 |
| 人脸检测模型 | 比如 face_yolov8m.pt,这是唯一必须自己放的文件 |
| 三个配套插件 | Impact Pack、VideoHelperSuite、H3 NativeAudioLock,示例工作流要用 |
| 显存 | 示例里附了一套压缩版模型,打开后 12 GB 显存能跑 H3 |
装好后在 ComfyUI 的 Workflow → Browse Templates 里能找到两个现成模板:一个按规则自动挑脸(默认挑最大的那张),一个让你手动选。
让 AI Agent 帮你装
我想用开源的 ComfyUI-H3-FaceRefine 修 MiniMax H3 视频里远处的人脸:https://github.com/Carasibana/ComfyUI-H3-FaceRefine
1. 先读它的 README,检查我的 ComfyUI 版本有没有自带 MiniMax H3 节点、显卡有多少显存,告诉我能不能跑、要不要用压缩版模型。
2. 列出要装的插件和要下载的模型,以及各自放在哪个文件夹,我同意后再装。
3. 装好后打开它自带的模板,先拿我的一段 5 秒左右的短片试一次,用 README 的默认设置。
4. 把原片和修过的片子各截同一帧给我对比,告诉我这一段花了多久。
5. 不要改我原来的工作流和模型文件。
用之前要知道
- 越长越慢:耗时大约跟画布面积乘帧数成正比。长视频如果自动选的画布太大、超出显存,它不会报错,而是悄悄改用内存,速度会慢一个数量级。先拿短片试。
- 帧数会被补齐:H3 的帧数只能是 5、22、39 这一串固定值,别的长度会被补到下一个值,多出来的帧修完再丢掉,只是多花点时间。
- 旧工作流要重连:1.1.0 版改了重画强度那个节点的接法,用 1.0.0 存的工作流打开会报缺输入,按 README 重新接一下模型线。
- 它会读本机任意路径的视频:不想让它碰 ComfyUI 文件夹以外的文件,可以设环境变量
H3_FACEREFINE_STRICT_PATHS=1。 - 只修脸,不修手和身体:远处的手指、衣服走样,这个插件管不了。
评论(0)
还没有评论,来说第一句。