


你会得到什么
想做知识类短视频、又不想出镜的人,可以把稿子交给能读写文件的 AI Agent(比如 Claude Code 或 Codex),让它按一个开源 Skill 做成手账风讲解视频:画面是卡片、步骤条和你自己的截图,声音是配音。文中有 2 段可以直接复制的提示词。
先放下"一键成片"的期待。 这套做法的关键是让 AI 每做完一步就停下,等你确认再往下走。配音、素材和前三秒由你把关;AI 负责排版、剪辑和检查。

为什么要一关一关地确认
一句话扔给 AI 直接出整片,常见的结果是字读不通、画面和台词对不上,只能整条重做。拆成几关之后,问题在最便宜的时候就被发现:
- 配音最先审:专有名词读错、停顿奇怪,画面再好看也救不回来。
- 素材先列清单再动手:每句台词配什么画面、缺什么,一眼就能看出来。
- 只做前三秒试水:字号、版式和节奏在三秒里就能看出问题,不用等整片渲染完。
第 1 步:备好四样东西
开工前把这几样准备好,做到一半再改最费时间:
- 一句话说清主题和观众,再定好平台和画幅。默认是 16:9 横屏,做竖屏要重新排版,不是改一下导出尺寸。
- 一份定稿。数字和说法都查过来源,AI 不会替你改。
- 你自己的截图或录屏。账号、余额和头像这类信息先打码。
- 配音。自己录,或者用你有权使用的配音工具生成,不要克隆别人的声音。
第 2 步:让 Agent 装上 Skill
打开 Claude Code 或 Codex,发这一句:
帮我安装这个 Skill:https://github.com/VaneAi888/vane-faceless-koubo-skill ,先读 README,按说明装到你的 skills 目录。
装好后检查做视频要用的工具(Python、Pillow、ffmpeg、一个中文字体)是否齐全,缺什么先告诉我,等我同意再装。
装好后新开一个对话。Agent 要遵守的规则、要用的脚本,都在 不露脸知识口播的 Skill 页面。
第 3 步:下一张任务单
在新对话里发下面这段。方括号换成你自己的内容:
第 2 条最重要:它把一次性的"生成"拆成了五次可以喊停的检查。第 5 条防止 Agent 为了"做完"替你点了发布。
第 4 步:先听配音,再看素材清单
Agent 第一个交上来的是配音和逐字稿。从头到尾听一遍,重点听专有名词、英文缩写和数字。哪里改了字,让它把配音和字幕一起改。
配音通过后,它会按台词列一张素材清单,每一行写清这句话配什么画面、东西从哪来:

看清单时问自己三件事:有没有一句话找不到画面;有没有拿无关的网图凑数;图表是不是用了真实数据,没有的话标没标"示意"。
第 5 步:只做前三秒
清单和分镜都通过后,先别做整片。让它用正式的画幅、字体和配音只渲染开头三秒:
先只做开头三秒样片,用正式画幅、字体和配音。做完发给我,等我确认再做全片。
这个 Skill 自带一个示例渲染器,下面是它做出来的一帧,能看出手账风大概是什么样:
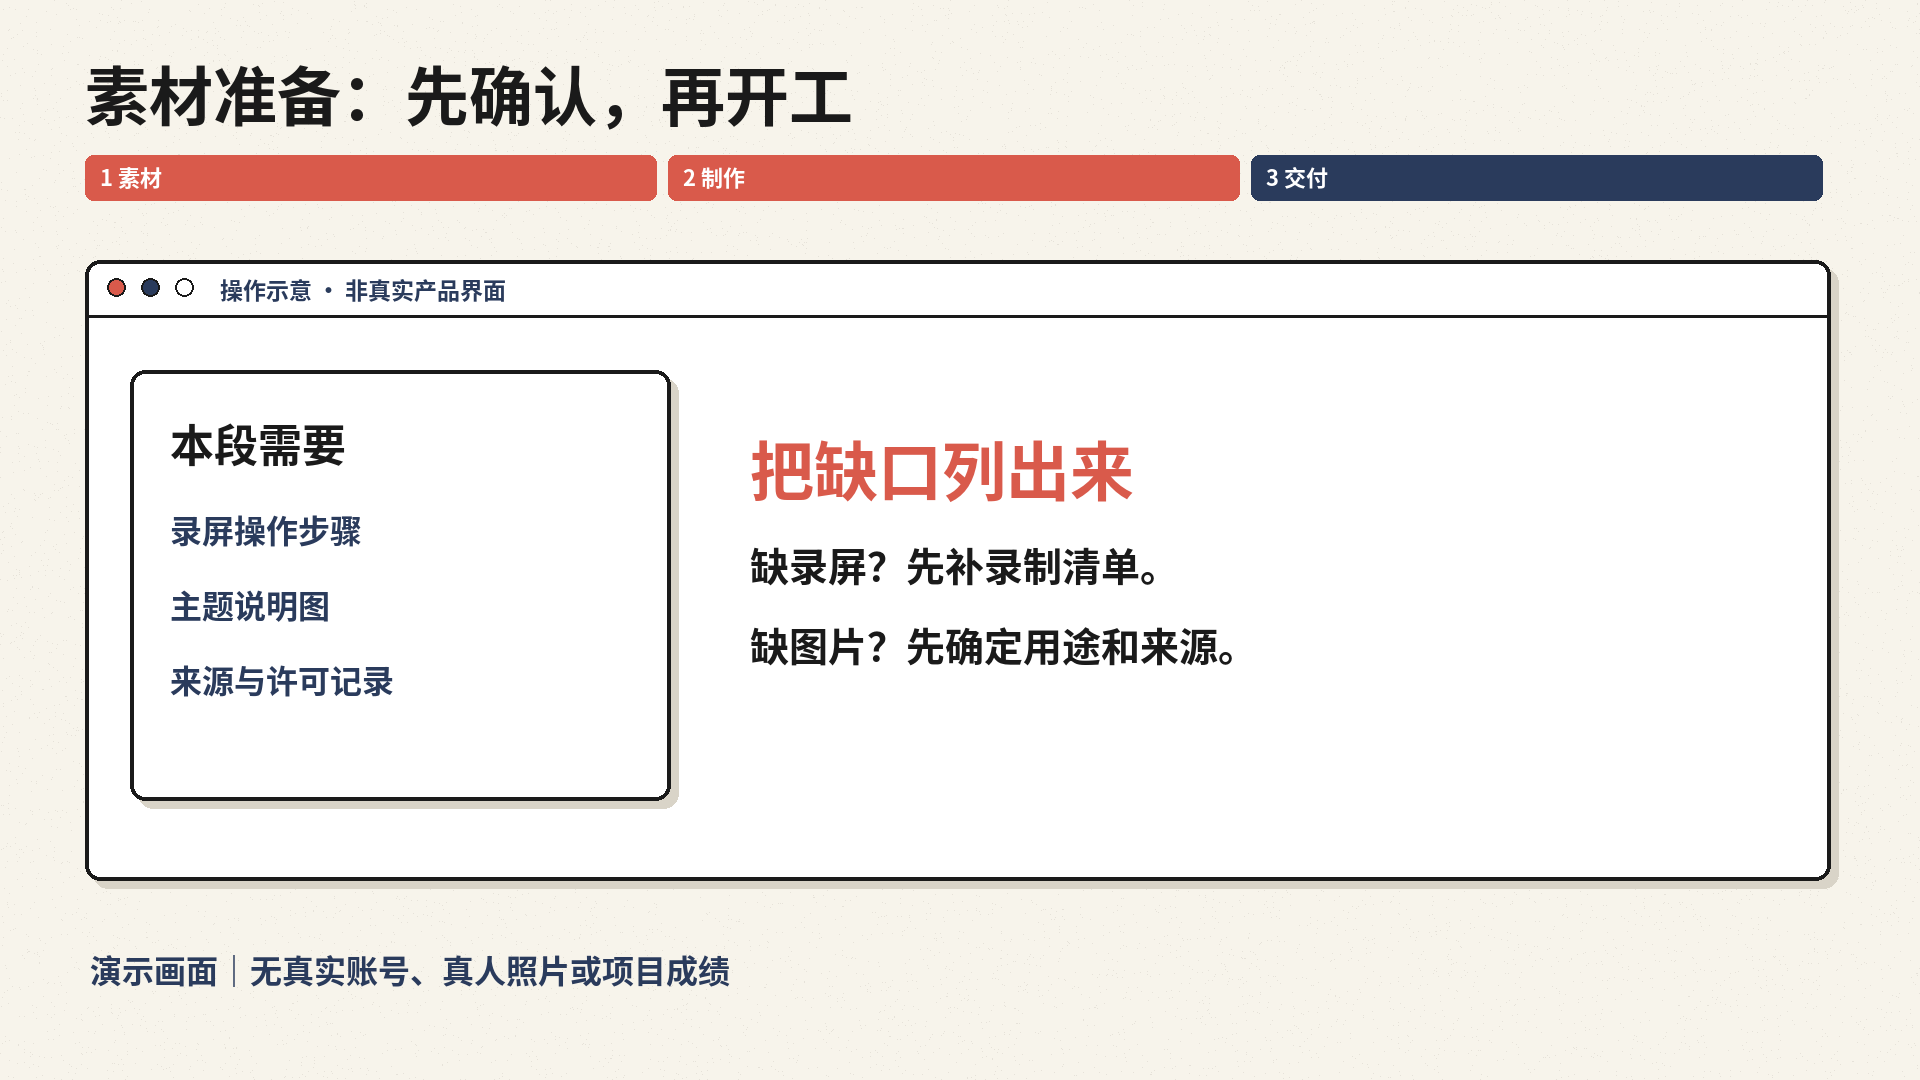
(图片来自项目仓库。)
在手机上看这三秒:字清不清楚,版面挤不挤,声音说的和画面打出来的是不是同一件事。三秒没问题,再让它铺开做全片。
第 6 步:看完整片,再自己发布
全片做完后,Agent 会跑一次技术检查,看时长、分辨率和响度,但这只证明文件没坏。你要自己完整看一遍、听一遍,留意转场、音画同步,以及字幕有没有被挡住。封面它会按 3:4、4:3、16:9 分别排版。
确认没问题后,由你自己发布。
注意
- 它不包配音和录屏:Skill 里没有语音合成、语音转文字和自动录屏,这几样要你自己准备。
- 脚本只是最小示例:附带的渲染器只做卡片、字幕、步骤条和静帧展示。复杂的录屏和分层剪辑,还要剪辑软件配合。
- 作者的作品不能拿来用:仓库里展示的真实视频、配音和人物图不在开源许可里,只供参考。
- 第一条会慢:五道关都要你看,第一条视频比"一键生成"慢得多,熟悉之后会快起来。
评论(0)
还没有评论,来说第一句。