

你会得到什么
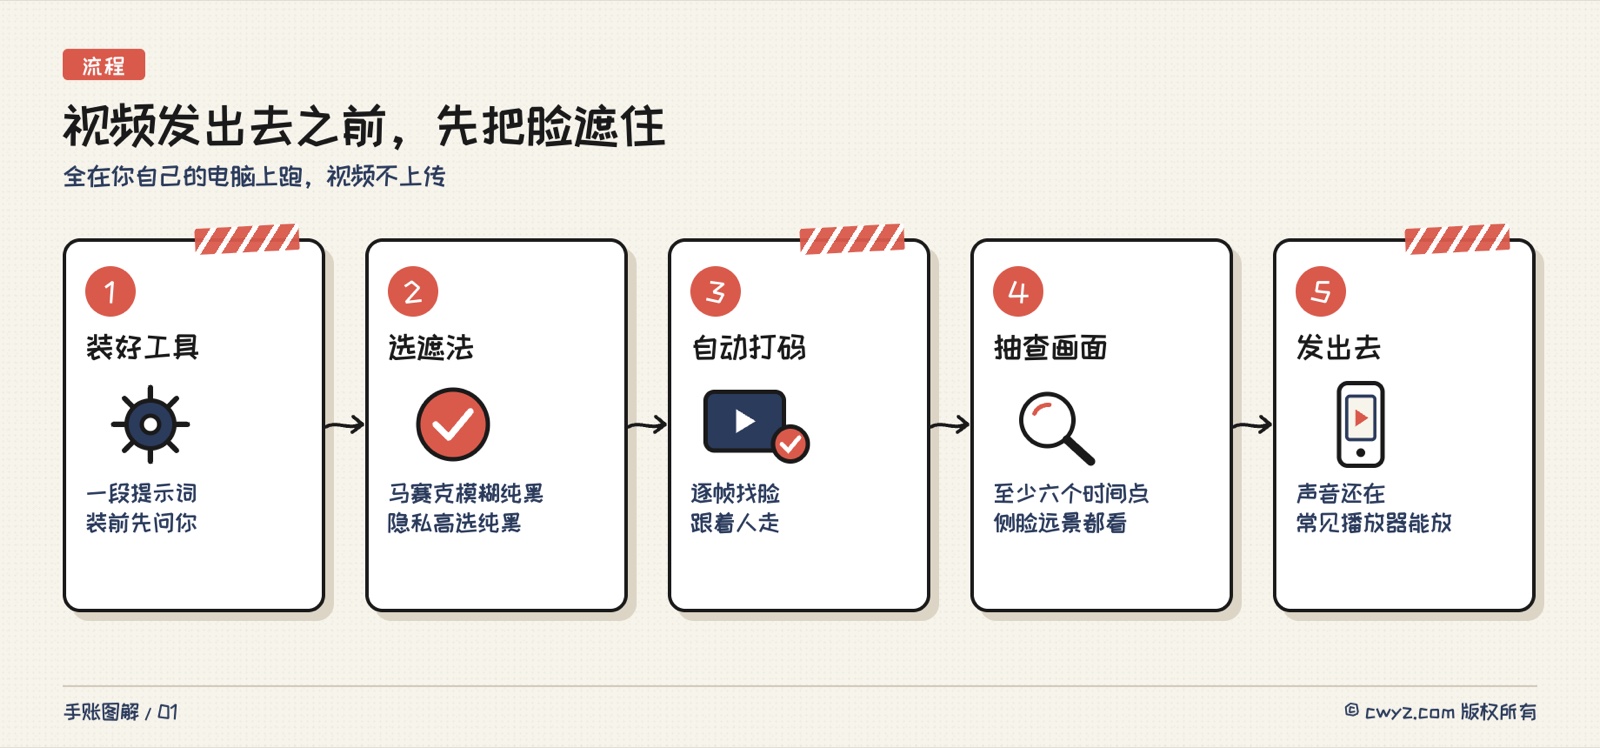
拍的视频里有路人、同事或孩子的脸,发出去之前想遮住?交给 AI Agent:它在你自己的电脑上一帧一帧找出所有人脸,跟着人走,加上马赛克、模糊或纯黑遮罩,声音和画面动作都保留,出来的视频手机、Telegram 和常见播放器都能直接放。视频不上传,免费。想让自己或主角露脸、只遮别人,也能做到:你选谁露脸,其他人默认打码。文中有四段可以直接复制的提示词。
用的是我们整理发布的 video-face-anonymizer Skill(写给 AI Agent 的专业说明书)。它能遮住绝大多数人脸,但不保证百分之百,所以最后一步一定要抽查。
先选遮法和检测方式
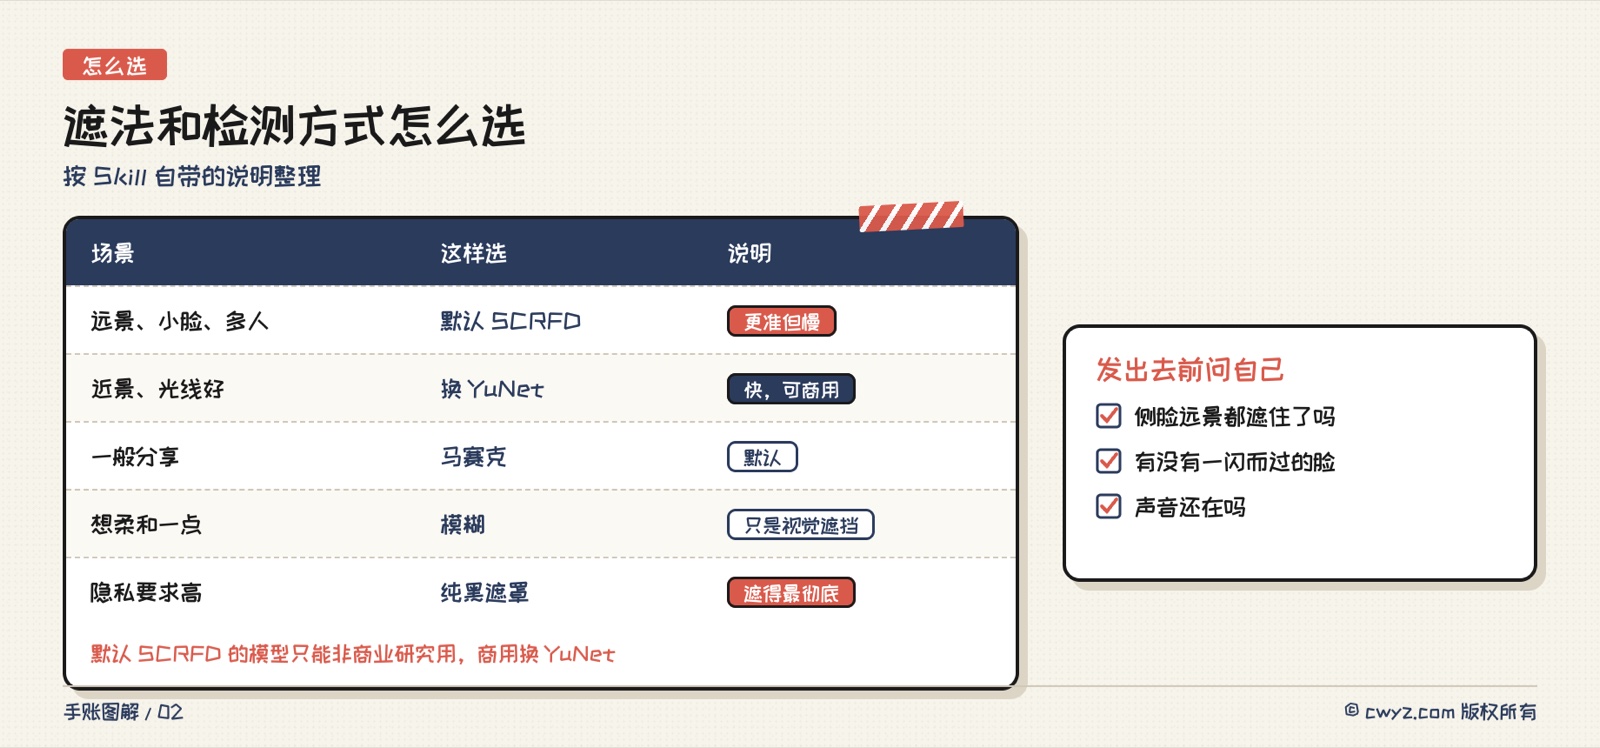
- 遮法:马赛克是默认;想柔和一点用模糊;涉及孩子、证人、不愿露面的人,直接用纯黑遮罩,遮得最彻底。马赛克和模糊只是视觉上看不清,不是加密。
- 检测方式:默认的 SCRFD 对远处的小脸、侧脸、暗光、多人画面更准,但在普通电脑上比较慢;近景、中景、光线好的视频可以换 YuNet,快很多。
- 商用要注意:默认 SCRFD 用的模型只允许非商业研究使用。给客户做的视频、商业项目,让 AI Agent 换成 YuNet(MIT 许可证)。
第 1 步:让 AI Agent 装好
请安装这个 Skill:https://cwyz.com/api/skills/video-face-anonymizer/raw
1. 先读完全文,用大白话告诉我它要装什么、会下载哪些模型、大概多大。
2. 检查我电脑上有没有 Python 和 ffmpeg。缺什么先告诉我,等我同意再装。
3. 把 Skill 里的 face_mosaic.py 存到我同意的文件夹里。
4. 装好后告诉我,下一步我把视频交给你。
第一次用默认检测方式时,会自动下载一个约 275 MB 的模型,提前说好可以避免你以为它卡住了。
第 2 步:交给它打码
第 4 条写清楚是不是商用,AI Agent 才能选对模型;第 5 条让它自己先查一遍格式和声音,免得发出去才发现没声。
第 3 步:抽查,确认没有漏网的脸
自动检测总有漏网的时候:一闪而过的脸、转头的瞬间、远处很小的人。发出去之前,让它截图给你看:
对比原视频和打码后的视频,在至少 6 个时间点各截一张对比图给我看,必须包括:
- 每个重要人物第一次出现的时候
- 最近和最远的脸
- 侧脸、歪头、被东西挡住又露出来的时候
- 开头、中间、结尾
如果哪张图里还能认出人脸,告诉我在哪一秒,然后调大检测尺寸、遮罩范围或保持帧数重跑,必要时改成纯黑遮罩,再给我看一遍。
截图对比是最可靠的检查:视频在动只能说明它不是一张静止图片,不能说明脸都遮住了。
只想让某几个人露脸
自己拍的 vlog 或采访,常常是主角要露脸、路人要遮,带孩子出门拍的视频也一样。把上面第 2 步换成这一段:
用 video-face-anonymizer 处理这个视频:[视频文件路径],只让我选的人露脸,其他人都打码。
1. 先用 --list-faces 把视频里的人列出来,把带编号的总览图给我看,等我说要露脸的编号。
2. 同一个人被分成了两组,就两组都算上;总览图里不是人脸的格子(手、台灯这类)不用管。
3. 用 --keep 只让我选的人露脸,遮法用 [马赛克 / 模糊 / 纯黑遮罩],输出存成 [文件名]-打码.mp4。
4. 不要为了让露脸的人少遮几帧去调低识别阈值。
5. 抽查时专门看:没选的人有没有在哪一帧露了脸,选中的人是不是大部分时间都露着。
你要做的只有一件事:看总览图,报编号。露脸的人刚出场的头几帧、转头或被挡住时会被短暂遮一下,这是故意的,认不准的时候它宁可多遮一下,也不让别人露脸。
长得很像的两个人(比如双胞胎)可能被认错,抽查时多看一眼他们同框的画面。
注意
- 不保证百分之百:极小、严重模糊或完全被挡住的脸可能识别不出来,高风险的视频一定逐段看一遍。
- 默认模型不能商用:SCRFD 用的 InsightFace 模型仅限非商业研究,商用换 YuNet。
- 普通电脑会慢:默认检测方式在 CPU 上跑,长视频要等一阵;赶时间且是近景视频可以换 YuNet。
- 这个 Skill 最早是在 Agent 交流群里分享的,讨论记录见 群聊专题报告(6 月至 9 月)。
评论(0)
还没有评论,来说第一句。