

你会得到什么
用三个开放权重的模型,在自己的电脑上做数字人口播:MiniMax H3 让一张照片开口说话,LatentSync 只给你已有的视频换嘴型,美团 LongCat-Video-Avatar 做一镜到底的长口播。从装环境到排错,都交给你的 AI Agent,全文有三段可复制的提示词。
本地跑不按条收费,花的是电费和等待的时间。它适合手上已经有好显卡、又要经常出片的人。一个月只做几条的话,在线服务或按分钟租云端显卡往往更省事。
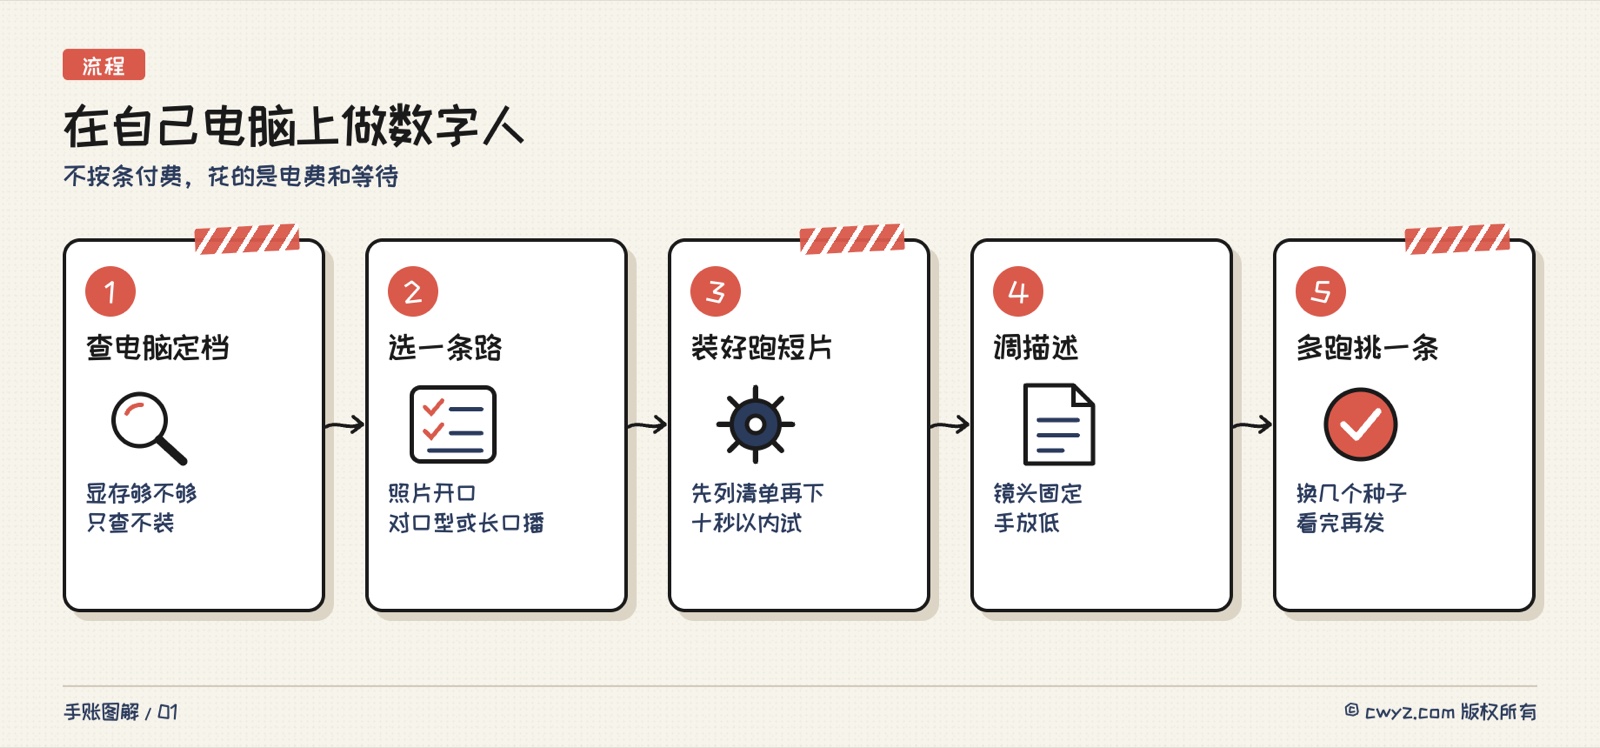
先查电脑能跑哪一档,再按手上的素材选一条路,装好后先跑一条短的,调好描述再多跑几次挑最好的。
先分清三条路
三条路的差别在于你手上有什么素材。下面的耗时和效果,来自一位创作者在 NVIDIA DGX Spark(121 GB 统一内存)上的实测,我们没有复现,换一台机器数字会不一样,只用来比较快慢。
| 你手上有 | 走哪条路 | 效果 | 做 10 秒大约要等 |
|---|---|---|---|
| 只有一张照片和一段配音 | H3 照片开口:从零画出整段视频,会眨眼、点头、做手势 | 动作最丰富,偶尔翻车 | 8 分半 |
| 照片,加十几秒自己说话的视频 | H3 带参考视频:让模型更认得你 | 更像本人,低头的角度也对 | 23 分钟 |
| 一段自己的口播视频 | LatentSync 对口型:原视频不动,只重画嘴巴那一块 | 最真实,但动作全是原视频里的 | 3 分半 |
| 照片和一段很长的配音 | LongCat 长口播:一段接一段往后生成 | 和 H3 一样像本人,动作收敛、会自然眨眼 | 26 到 71 分钟,看清晰度 |
新手先走对口型:只要你有一段正脸的口播视频,嘴没被挡,头也不大幅转动,它最容易一次出效果,也最快。H3 单次最多十几秒,长了要分段拼接。要做几分钟的长口播,再考虑 LongCat(它的介绍见 美团开源数字人 LongCat-Video-Avatar 1.6)。
第 1 步:让 AI Agent 查清你的电脑能跑哪一档
模型必须整个装进显存(普通显卡自带的内存)或统一内存(DGX Spark、苹果芯片这类 CPU 和显卡共用的内存)才能跑,装不下就会报错退出,俗称"爆显存"。一个数字人方案往往要同时装好几个模型:画画面的主模型最大,另外还有读懂描述的文本编码器、压缩画面和声音的 VAE。
按那位创作者的实测和各项目的官方说明,大致分三档:
- 16 GB 显存的游戏显卡(例如 RTX 5070 Ti):H3 跑 6 秒以内的片段没问题,拉到 12 秒会爆显存。LatentSync 1.5 官方写的推理最低 8 GB,1.6 要 18 GB。
- 24 到 32 GB 的高端显卡(例如 RTX 4090、5090):H3 主模型文件本身就比显存大,能否运行取决于软件支不支持把模型拆开、轮流放进显卡,目前没见到实测,买卡前先找同款卡的人问。
- 显存或统一内存在 100 GB 以上:三条路都能走,H3 能做到 15 秒,LongCat 能出 720p。
这些模型都基于 NVIDIA 的 CUDA,其他牌子的显卡没人试过。把下面这段交给你的 AI Agent,它只检查、不安装:
我想在这台电脑上本地做数字人口播视频,候选方案有三个:MiniMax H3(照片加配音生成说话视频)、LatentSync(给已有视频对口型)、LongCat-Video-Avatar(长口播)。
请先只读检查,不要安装任何东西:

1. 系统是什么,有没有 NVIDIA 显卡,型号和显存多大;如果是一体机或 Mac,统一内存多大,CPU 是 x86 还是 ARM
2. 各个硬盘还剩多少空间(这些模型加起来要上百 GB)
3. 有没有装过 ComfyUI、Python、CUDA,各是什么版本

查完用大白话告诉我:
- 三个方案里哪几个能在这台电脑上跑,能做多长的视频
- 跑不了的,最接近的替代办法是什么(比如换压缩版模型、缩短时长、租云端显卡)
有拿不准的用选择题问我,做完停下等我确认。
先只读检查,是为了确认显存和硬盘都够了再下载,免得下了上百 GB 才发现跑不动。如果检查结果说 CPU 是 ARM 架构(DGX Spark 就是),提前做好心理准备:很多 AI 软件按 x86 写,那位创作者装对口型时踩了十来个坑。
第 2 步:让 AI Agent 装好并跑通第一条
选定路线后,准备好素材再交给 Agent:
- 照片:半身照,脸清楚、光线均匀,最好就是你希望视频里出现的取景距离。
- 配音:先用 10 秒以内的一段,跑通了再加长。
- 口播视频(对口型或参考用):要正脸,嘴不被手或话筒挡住,头也别大幅转动。时长比配音稍长一点。
把"先列清单等确认"写进去,是因为这几个模型的文件动辄几十 GB,下错版本很浪费时间。第一条压到 10 秒以内,出错快,也好排查。
第 3 步:调描述,别让 AI 把手怼到镜头前
照片开口这条路,动作全靠你写的描述。AI 很听话,你写了什么,它就把什么放大:
- 描述里要了自拍式的近景和丰富手势,人物就会把双手举到镜头前,挡住半个画面。
- 描述成讲解教程,人物会一直竖着食指比划。
- 改成"镜头固定,保持照片原来的距离,像跟朋友聊天,手掌自然摊开,说完一句偶尔把手放下",动作就正常了。
负面描述(不想要的东西)也一起写上,例如"字幕、模糊、多余的手指、镜头晃动"。想让 Agent 帮你改,可以把这段交给它:
我用 [H3 / LongCat] 做数字人口播,刚生成的视频问题是:[比如手老是挡住脸 / 动作太僵 / 嘴型夸张 / 场景变了]。
现在的描述是:[粘贴原描述]

请帮我改写描述和负面描述:
1. 写清镜头固定、和照片保持同样的距离、手放低这类约束,不要写会被放大成夸张动作的词
2. 每次只改一处,告诉我改了什么、为什么
3. 用同一个种子重跑,方便和上一条对比
第 4 步:多跑几条,挑最好的再发
参数一个没改,重跑一遍也可能出来另一个样子。决定这一点的是种子(seed),就是每次生成的起点编号:种子不变、其他设置不变,结果就一样,换个种子就等于重新摇一次号。那位创作者换过 3 个种子,有一条连天色都变了,夜景成了白天。
所以正式出片时,让 Agent 用 3 个左右的种子各跑一条,你从头到尾看完再挑。有些毛病换种子也压不下去,比如偶尔嘴会噘成一个"O"形,碰到了就换句子或换一种描述,实在不行就换一条路。
看懂设置里的几个词
ComfyUI 这类工具的设置项很多。新手大多用模板默认值就行,下面这些知道意思,跟 Agent 沟通时更顺:
| 设置 | 是什么 | 怎么调 |
|---|---|---|
| 步数(steps) | 模型从一屏噪点开始,一遍遍修出画面的遍数 | 耗时基本和步数成正比,加速版模型几步就够 |
| LoRA | 挂在主模型上的小补丁,几 GB 大,给模型添一个新能力,卸掉后主模型原封不动 | 可以调强度,1.0 代表全开,补丁叠得多未必更好 |
| turbo / 蒸馏版 | 专门训练成"几步就画完"的快速版,常以 LoRA 发布 | 显卡慢时优先找它 |
| 采样器(sampler) | 每一步具体怎么修的算法 | 用模板默认值 |
| 精度:BF16 / INT8 | 模型里数字记得细还是粗;INT8 体积约为一半,画质一般看不出差别 | 显存不够先找 INT8 这类量化版 |
| 分辨率、帧率、帧数 | 画面多大、每秒几张、一共几张 | 分辨率越高越慢,有的模型对帧数有固定要求,让 Agent 按模板算 |
注意
- 只用有授权的脸和声音:用自己的,或者拿到本人同意的。别人的照片和声音做成数字人,可能侵犯肖像权和声音权益。发布时按平台要求标注 AI 生成。
- H3 的许可证有地区限制:它的开放权重许可证目前不覆盖美国、欧盟、英国和韩国,这些地方的用户要先向 MiniMax 申请授权。LatentSync 是 Apache-2.0,LongCat-Video-Avatar 是 MIT。
- 电费便宜,时间不便宜:那位创作者按整机 100 瓦估算,一条 10 秒视频的电费大约一分钱,没有实测插座。主要花销其实是买机器,再加上每条几分钟到一个多小时的等待。
- 真人出镜仍然是最稳的选择:数字人适合批量、补镜头和不方便出镜的时候,重要的视频还是自己拍。
想把 H3 出的低清视频放大成高清,接着看 让 AI Agent 帮你把 AI 视频放大成高清。
评论(0)
还没有评论,来说第一句。