


Sherlock 是开源情报(OSINT,指从公开信息里查线索)圈里用了很多年的老工具,GitHub 上超过 10 万星。给它一个用户名,它会挨个去 400 多个网站(当前站点清单里有 481 个)看这个名字有没有被注册,几分钟后列出所有"疑似存在"的主页链接。安全研究员、调查记者、品牌方都在用。真正该先拿它查的人是你自己:它扫出来的清单,就是别人能顺着一个用户名摸到你的路线图。
先看它能查出什么
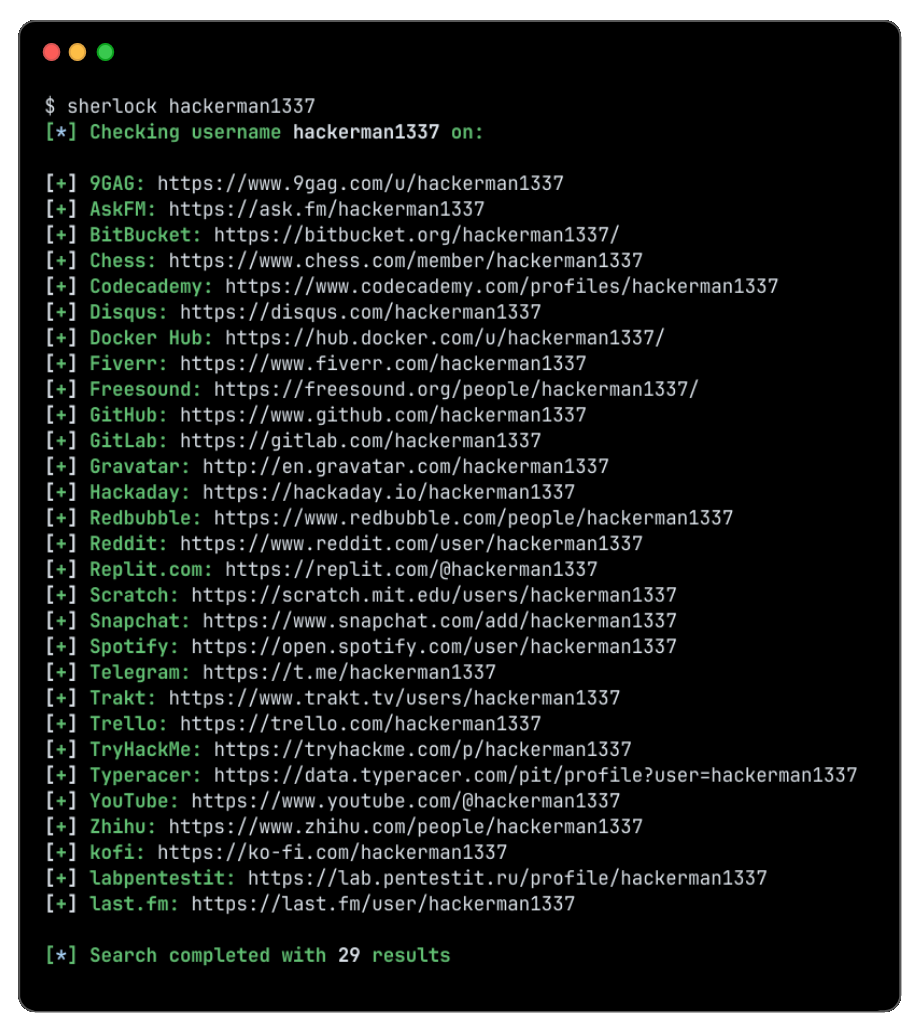
(图片来自 Sherlock 仓库,示例用户名是虚构的。)
整个过程分三段:
| 环节 | 做什么 | 产出 |
|---|---|---|
| 输入 | 一个或几个用户名;可以用 {?} 代表"下划线、短横线、点"三种写法一起查 |
要查的名字清单 |
| 扫描 | 按内置的站点清单,访问每个网站上这个名字的主页地址,按网站的反应判断账号在不在 | 每个网站"找到 / 没找到" |
| 输出 | 找到的主页链接,可以存成文本、CSV 或 Excel 表格 | 一份能逐条点开核对的清单 |
它只看公开主页能不能打开,不登录、不破解、不读私密内容。也正因为只看"页面在不在",结果里会有误报:有的网站对任何名字都返回一个页面,有的会拦截自动访问。所以清单只是线索,每一条都要点开确认。
功能按 Sherlock 官方仓库和网站的说明整理(当前版本 v0.16.2,MIT 许可证),我们没有逐项实测。
为什么值得用:三个原因
- 人会在不同网站反复用同一个名字。 十年前注册的论坛号、早就不用的作品集、随手建的测试账号,名字往往一样。一个用户名就能把它们串起来,这正是你需要提前知道的。
- 它把几个小时的手工活变成几分钟。 自己挨个网站搜,查二三十个就累了;它一次查几百个,还能直接导出表格。
- 清单是公开维护的。 站点规则放在一个公开的数据文件里,网站改版导致判断失灵时,社区会更新或把它移出清单,不靠某个人的经验。
照着用:五步 SOP

下面以"查清自己或自家品牌在网上留下了哪些账号"为例。把它交给你的 Agent,让它每完成一步对照"完成标准"自查。
安全底线
- 只查自己、自家品牌或有书面授权的对象。 拿它去查前任、同事、网上吵过架的陌生人,属于跟踪和人肉,很多地方违法。
- 结果不公开。 把某个人的账号清单发到网上,本身就可能伤害到人,即使每个账号都是公开的。
- 不凭一个同名账号下结论。 同名不等于同一个人,误认会冤枉别人。
- Agent 只读不动手。 注销、注册、申诉这类动作由你自己来做。
容易踩的坑
- 把清单当结论。 有的网站对任何名字都显示页面,结果里会混进不存在的账号;不逐条点开核对,处理清单就会出错。
- 只查现在的用户名。 真正暴露隐私的往往是十年前的旧名字,第 2 步要把旧名字和变体写全。
- 开了"忽略排除名单"。 官方说明这样会带来更多误报,自查时不需要。
- 公司网络或代理导致大量"打不开"。 有些网站会拦截自动访问,换个网络环境再查一次那几个,而不是直接当作"没有"。
- 查完不处理。 清单的价值在第 5 步:不用的旧账号注销或设成私密,才是真正缩小了暴露面。
项目地址:Sherlock(GitHub);官方网站:sherlockproject.xyz,安装和用法见 安装说明 和 使用说明。
常见的翻车点
- 01把扫描清单当结论,不逐条核对。
- 02只查现在的用户名,漏掉旧名字。
- 03开了忽略排除名单,误报变多。
- 04网络被拦截导致大量打不开,被当成没有。
- 05查完不处理旧账号。
评论(0)
还没有评论,来说第一句。