


剪口播视频,最费时间的往往不是剪,而是配画面:一句话讲抽象概念,素材库里找不到对应的画面。有人把这件事做成了一个开源 Skill,叫 gbro-collage-broll:你给它一句 5 秒左右的口播,它先帮你想一个视觉隐喻,再做成半调纸拼贴风的组装动画。
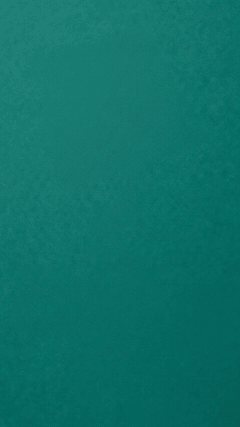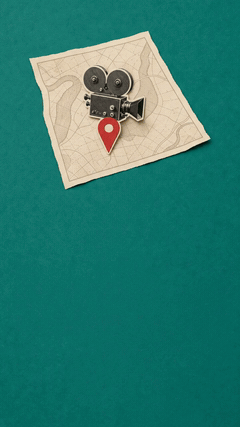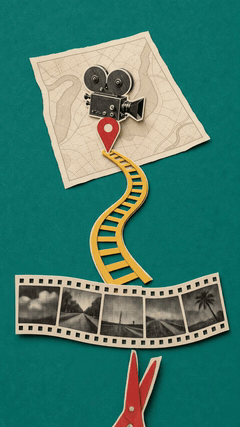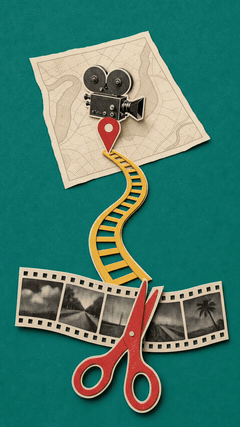
下面这些是项目自己放出来的示例:


图片来自项目仓库 README。
它做出来的是什么
- 画面是一块平整的纯色纸面,上面是黑白半调的照片剪贴,加少量彩色卡纸。
- 纸片从空场开始,一件件滑进来卡到位置,有定格动画的质感,不是淡入加慢推。
- 默认成片:竖屏 9:16、5 秒、720×1280,没有声音,直接垫在口播下面。

最聪明的设计:三道确认
这个 Skill 的核心不是一段提示词,而是强制的三道确认:
作者的理由很实在:**改文字不花钱,重生一张图便宜,重跑一条视频才贵。**所以把你的注意力留给审美判断,把花钱的步骤放到最后。批量做的时候,也只有你点过头的条目才会进入下一步。
上手前先看门槛
这不是装上就能用的一键工具,先看清楚:
- 静帧靠 Codex 自带的生图。 在别的 Agent 里,需要你自己准备等效的生图方式,或者直接提供静帧图。
- 视频走你自己的 Gemini 密钥,按量付费。 费用由这把密钥对应的 Google 账号承担,具体价格以 Google 官方为准。
- 需要 ffmpeg 和 Python 3.10 以上。 用来处理首尾帧、去音轨和做检查图。
- 第一次使用时,Skill 会先运行自检,缺什么就告诉你缺什么。
装法和技术细节都放在 Skill 页面里,把它交给你的 Agent 就行:口播 B-roll 纸拼贴动画。
实操:从一句口播到一条成片
第 1 步:给它一句口播
对 Agent 说:
collage b-roll:很多人以为 AI 是来替你思考的,其实它更像一面镜子,会把你问题里的漏洞照出来。
触发词还有"纸拼贴 b-roll""半调拼贴""拼贴风格配画面"。一次给多句也可以,每句一个隐喻、一条成片。
第 2 步:第一道,只看隐喻
你会收到每一条的核心意思、情绪、一句话的视觉命题、3 到 6 个关键物件、底色和组装顺序。这一步只是文字,不要急着点通过,问自己三件事:
- 观众看到画面,能不能一眼懂这句话?
- 物件会不会太多?多了会让意思变弱,动画也不稳。
- 底色和语意搭不搭?
不满意直接说"把镜子换成……",改文字不花钱。
第 3 步:第二道,看静帧
隐喻通过后,才会出最终静帧和一张总览图。重点看:
- 隐喻是否清楚、主体是否集中;
- 画面里有没有假字、logo 或水印;
- 是否留出足够的纯色空场(因为动画要从空场开始组装);
- 元素是不是 3 到 6 个清晰的大组,而不是满屏碎片。
不满意就让它重生这一张,旧的总览图会保留,方便对比。
第 4 步:第三道,生成视频
静帧通过后,Skill 会自动用首尾帧做视频:首帧是同底色的空纸面,尾帧是你确认过的静帧,中间由模型补出纸片滑入卡位的过程。生成后它会逐秒抽帧做检查,并把末帧和你确认的静帧并排对照。
第 5 步:自己再看一遍
- 首帧是不是接近空场?
- 中间是不是真的一件件进入,而不是整体淡入?
- 有没有切镜、突然放大或变形?
- 最后一帧有没有偏离确认过的静帧?
轻微的姿态变化不影响意思就算通过,不必为此重跑,重跑是要花钱的。
容易踩的坑
- 首帧边缘露出一点纸片: 轻微可以接受;要求严格空场的,建议改用可编辑时间线的动画工具补前段。
- 组装感弱: 减少元素,让动作改成明确的"逐件滑入、卡位"。
- 出现假字: 回到静帧重生,不要指望视频阶段修。
- 想要精确控制图层或镜头: 这个 Skill 不适合,它不拆透明图层,也没有可编辑时间线。
- 想要真人出镜或产品广告: 不要用它。
- 密钥安全: 密钥只放在环境变量里,不要贴给任何人,也不要写进文件。
如果不想花视频的钱
作者在社交平台上演示过:用 Codex 调用图像模型直接出 GIF,连视频模型都不跑。这是他的说法,我们没有核实,而且仓库里默认仍然是 Omni Flash 做首尾帧视频。你可以先只走前两道,拿静帧做一张静态的配图,满意了再决定要不要生成视频。
想让 Agent 直接做,把 口播 B-roll 纸拼贴动画 交给它。
参考
- gbro-collage-broll,MIT 许可证
评论(0)
还没有评论,来说第一句。