

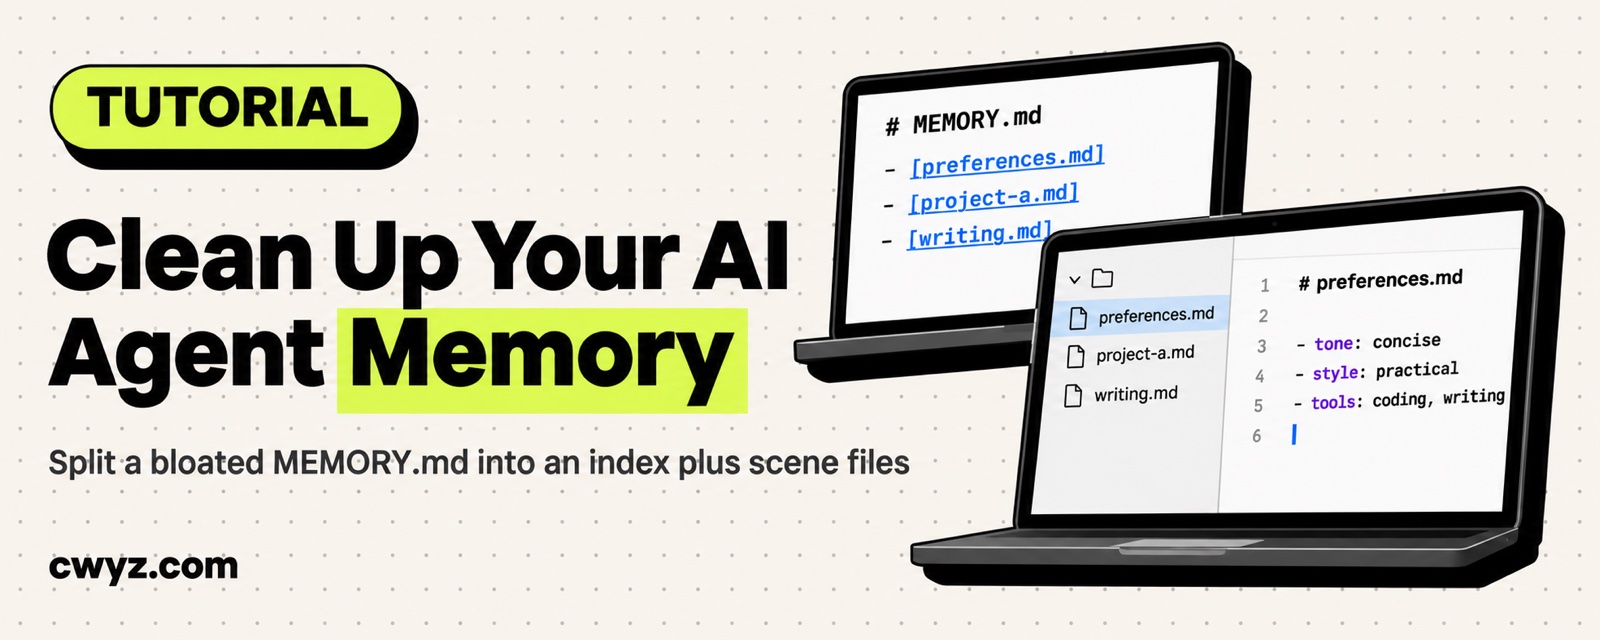
AI Agent 越用越蠢?把它的记忆文件做一次断舍离
你会得到什么
用一段提示词让你的 AI Agent 自己动手整理它的记忆系统:把塞满了的 MEMORY.md 拆成一份精简索引加多个分类文件,之后每次对话只加载当前任务需要的那份记忆。适用于 Claude Code、Codex、Meta Muse 等带记忆功能的 AI Agent。
记忆不是越多越好,Agent 一次能消化的信息有上限——过了这个量,每件事都记不清。
为什么记忆会拖慢 Agent
AI Agent 开始一段新对话时,会先把记忆文件读一遍。记忆越长,它花在理解"之前发生过什么"上的精力越多,分给"你现在要我做什么"的精力就越少。
具体来说会出三种症状:
- 跑偏:你让它改一段代码,它突然开始聊上周那个不相关的项目,因为记忆里两件事挨在一起
- 矛盾:早期存的偏好和后来改过的偏好同时存在,它有时候听旧的有时候听新的
- 变慢:记忆文件超过几百行之后,光是读记忆就占掉了很大一块上下文窗口
根本原因是 Agent 的上下文窗口是有限的。记忆塞得越满,留给当前任务的空间越小。
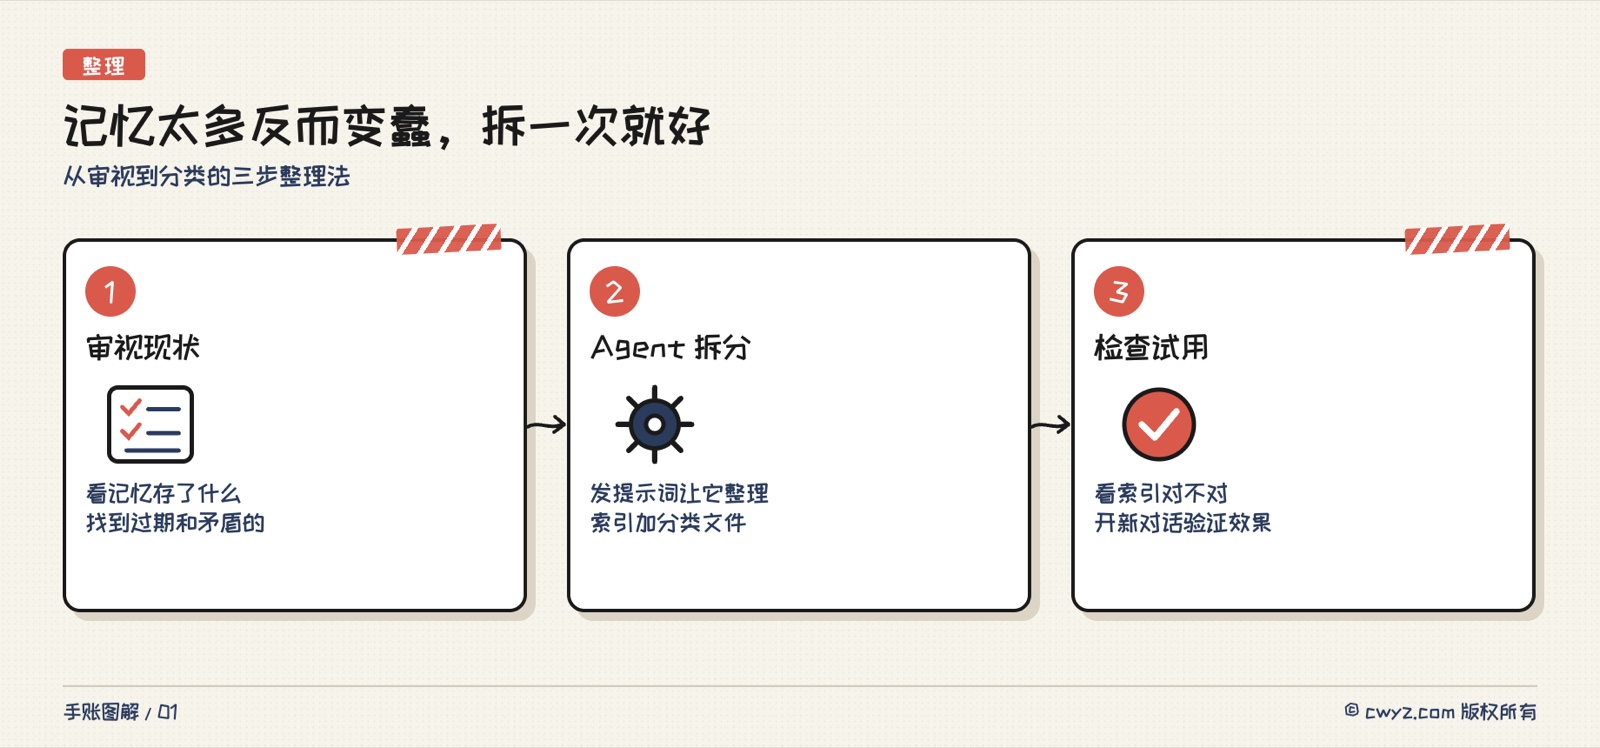
第 1 步:审视你现在的记忆状态
在开始整理之前,先看一眼你的 Agent 记忆里到底存了什么。
Claude Code 用户在终端输入 /memory 就能看到 MEMORY.md 的内容。Codex 用户看 ~/.codex/AGENTS.md 或者记忆目录。Meta Muse 用户在设置里查看 Memory。
看的时候留意这几样东西:
- 存了但再也没用过的(三个月前某个项目的临时决定)
- 互相矛盾的记录("我喜欢用 TypeScript"和后来的"这个项目用 JavaScript"同时存在)
- 特别长的段落,其实可以拆成独立文件的(整个项目的技术栈说明)
如果记忆超过 100 行,或者你发现 Agent 最近经常答非所问,就值得做一次整理了。
第 2 步:让 Agent 自己整理
把下面这段提示词发给你的 AI Agent。它会自己读现有记忆,按类型拆分,建好索引。
这段提示词没有指定记忆文件存在哪个目录——不同的 Agent 记忆的存储位置不同,让它自己找更靠谱。它会根据自己能访问的文件来操作。
注意第 5 步的"删之前让我确认",这是给你留的一道安全门。Agent 判断"临时"和"过期"不一定准,自己过一遍比较稳。
第 3 步:检查整理结果
Agent 整理完之后,你要做两件事:
看索引:打开精简后的主记忆文件,确认索引里的分类合理,路径能对上文件。好的索引长这样:
## 记忆索引

- 长期偏好 → memory/preferences.md(每次对话都读)
- 项目 A → memory/project-a.md(做项目 A 时读)
- 项目 B → memory/project-b.md(做项目 B 时读)
- 写作风格 → memory/writing.md(写文章或邮件时读)
试一次:开一段新对话,让 Agent 做一件它之前容易跑偏的事,看看表现有没有变好。如果还是跑偏,可能是索引里的"什么时候该读"写得不够明确,改精确一点。
注意
- 不是所有 Agent 都把记忆存在文件里。如果你用的 Agent 只有一个文本框记忆(比如 ChatGPT 的 Memory),思路一样——精简内容、按场景分段——只是不能拆文件
- 整理完不代表以后不用管。每隔一两个月检查一次,删掉过期的项目记忆,更新变化的偏好
- 记忆文件不是越细越好。拆太碎反而增加 Agent 判断"该读哪个"的负担,一般 5 到 10 个分类文件就够了
- 如果你有多个项目在同时推进,按项目拆比按主题拆更实用
参考
- Agent 入门 13:让 Agent 记得你——讲清记忆的三种类型和底层原理
- 交出几千篇笔记后才发现最该教 Agent 的是不做什么——用 Obsidian 管理笔记时的护栏思路,和记忆整理相通
评论(0)
还没有评论,来说第一句。