


竖屏短视频里有一种很吃香的形态:角色是扁平的 2D 卡通,场景却是打了光的 3D,把一个真实的历史或科学故事讲给你听。这种"2.5D"风格看起来像请了一个小剧组,其实一个人加一个 Agent、Blender 和几个开源 Skill 就能搭出一条流水线。
这篇教程带你从零走完一集:选题、脚本、分镜、搭场景、放角色、配音、字幕、声音,到最后的评审循环。每一步都给了可以直接改了用的提示词。
先说清楚:我们不知道任何具体频道背后的真实流程,下面是用开源工具搭出同类形态的一种做法。
学完你能做到
- 拆解一个参考视频的形态(尺寸、镜头节奏、字幕样式),而不是抄它的内容。
- 用 Agent 在 Blender 里分三遍搭出有光影的场景。
- 把 2D 角色放进 3D 场景里,并让它们"站得住"。
- 用自己的声音加逐字时间戳做字幕,再用声音检查工具把关。
- 用"截图墙加评审"的方式迭代,而不是反复看完整成片。
- 把整套流程打包成一个自己的 Skill,下一集只需要一句话。
准备
- Claude Code 或其他支持 Skill 和 MCP 的 Agent。
- Blender(按各项目说明,版本不要太旧,装之前看 README)。
- Python、Node.js、uv 和 ffmpeg。
- 一个能录音的麦克风。
- 心理准备:这是进阶教程,第一集会比较花时间。
装任何第三方 Skill 或 MCP 之前,先打开仓库读一遍。它们会在你的电脑上运行代码。
第一部分:这种形态长什么样
先认清楚参考视频到底做对了什么,再动手。常见的组合是:
| 项目 | 常见做法 |
|---|---|
| 画幅 | 竖屏 1080×1920,30 帧每秒,约 55 到 70 秒 |
| 内容 | 一个真实故事,一个人的声音讲完 |
| 角色 | 扁平 2D:圆脑袋、点状眼睛、粗描边 |
| 场景 | 完整的 3D:有光、有材质、有景深 |
| 镜头 | 大约每 2 秒换一个镜头,镜头运动是慢推或推轨 |
| 字幕 | 一次一到两个词,粗体白字,偏下居中 |
| 开头 | 用一个问句做钩子,比如"为什么……" |
它不容易被说成"AI 糊弄",有几个原因:角色故意做得简单,所以不会有恐怖谷;场景故意做得丰富,反差就成了标志;每个镜头都对应脚本里的一个新想法,而不是按计时器换;用的是真人声音;讲的是能被查证的真故事。
用 Agent 拆解参考视频
先把参考视频抽成缩略图:
mkdir -p frames
ffmpeg -i reference.mp4 -vf "fps=2,scale=540:-2" frames/ref-%04d.jpg
再把下面这段交给 Agent:
把 reference.mp4 当作"形态"来分析,不要当作要复制的内容。
先用 ffprobe 报出尺寸、帧率和时长,再逐张看 frames/ 里的图。

输出 REFERENCE.md,包括:
- 每一次切镜的时间点和帧号
- 每个镜头里哪些是 2D、哪些是 3D
- 每个镜头的镜头运动和方向
- 字幕样式:一张卡几个词、放在哪、什么时候换
- 钩子那一句,以及反转出现的位置

每个数值标注来源:已测量(从画面读出)、估计(目测)、决定(我们这一版的创作选择)。
拿不准的,指出我该核对哪几帧。
不要照搬角色、设计、脚本或故事结构。
最后给我 5 条这一集的创作决定。
标签要保留。Agent 从图片里估算的空间关系只是近似,凡是要拿来施工的数据,都要回到画面上核对。
第二部分:搭工作室
只装这一集需要的东西:
# 让 Agent 控制 Blender(需要先装 uv)
uvx mcp-for-blender setup
# 手动方式:claude mcp add blender uvx mcp-for-blender
# 安装 Blender 插件:uvx mcp-for-blender install-addon

# 动效的节奏和缓动,含迪士尼动画原则
npx skills add LottieFiles/motion-design-skill

# 合成画面、字幕和声音
npx skills add remotion-dev/skills

# 逐词时间戳,给字幕用
pip install -U openai-whisper
mcp-for-blender 的 README 还说明了如何接入素材库。Poly Haven 的素材是 CC0,用在带收益的视频里也不需要署名。
把"家规"写进 CLAUDE.md
Agent 每次启动都会读 CLAUDE.md。把形态写进去,每一集就都从同一套规则出发:
第三部分:先把故事写好
脚本只有 160 字左右
一条 65 秒左右的短片,按正常语速大约是 150 到 170 个字。这就是全部预算。让 Agent 找题材,但必须带出处:
找 5 个真实的历史或科学故事,适合用"那个……的东西"或"为什么……总是……"
这样的标题。

每个故事给:一句话概括、为什么十二岁的孩子和五十岁的大人都愿意转述、
两个我能打开的来源链接。

我选定一个后,写脚本:
- 150 到 170 字,一个叙述者,口语,短句
- 第一句是钩子,并提出一个承诺
- 大约第 40 秒有一个反转
- 最后一句兑现钩子
- 另写 sources.md,每一条事实都有出处
出处要你自己点开看。这是整条流程里唯一不能完全交出去的一步。
把脚本拆成镜头
分镜表是后面所有工作的合同:
把 script.md 拆成分镜表。一个想法一个镜头,每个 1.5 到 3 秒。

每个镜头写:编号、覆盖的台词、时长、
场景(哪个 3D 场景的哪个位置)、镜头(景别和运动及理由)、
角色(谁在画面里、姿势、用表情表里的哪一个)、
道具(关键道具必须用 3D 做,不能画)、
声音(只有发生物理动作时才写)。

场景要复用:65 秒的片子只应该用 3 到 5 个场景,而不是 30 个。
再把关键节拍写成帧号,而不是秒。下面是一个我们自己编的例子(30 帧每秒),数字只是起点:
全局帧   时间    事件
600      20.0s   镜头 9 开始:全景,夜里,宫殿很安静
615      20.5s   开始慢推,缩放 1.00 → 1.05,持续 45 帧
630      21.0s   油灯被碰倒
636      21.2s   灯落到地面(碰撞声放在这一帧)
640      21.3s   切到镜头 10:主人公睁眼
物理会让你诚实:一个东西下落约 30 厘米,大约需要四分之一秒,也就是 30 帧每秒下的 7 到 8 帧。做慢了会显得飘,观众说不出原因,但能感觉到。
用帧号以后,每次修改都是一个数字:"把碰撞往前挪 2 帧",Agent 不会理解错。
第四部分:在 Blender 里搭场景
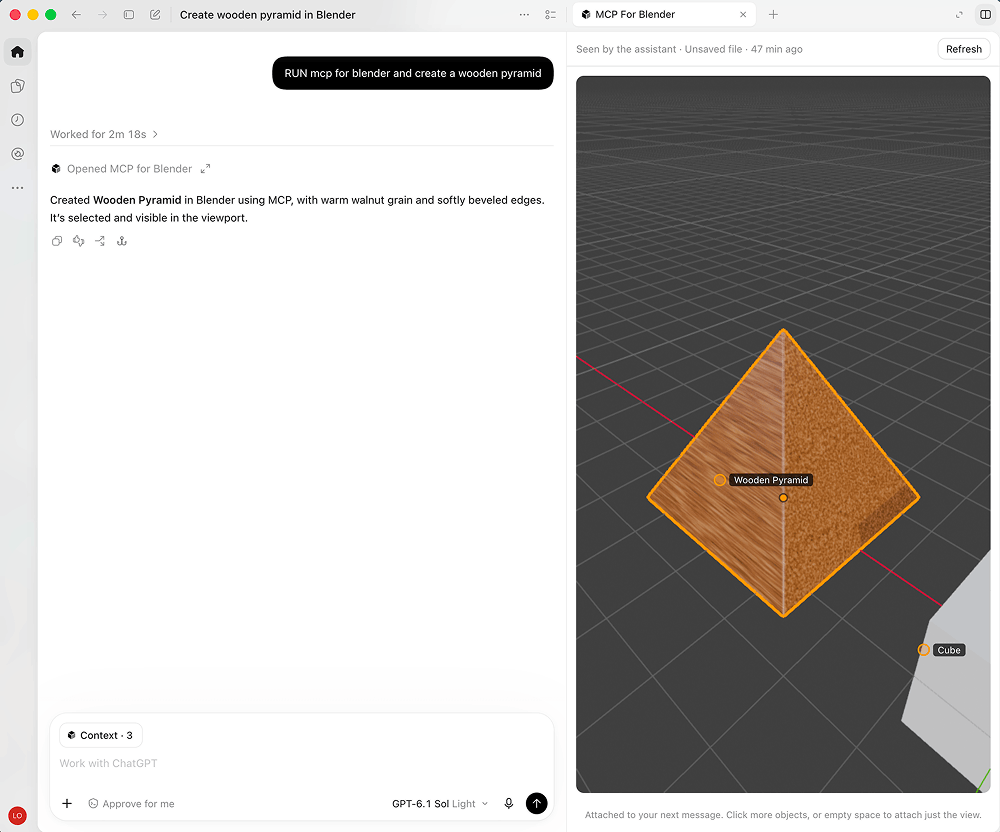
图片来自 mcp-for-blender 仓库。
mcp-for-blender 会在 Blender 里起一个小服务,让 Agent 直接写 Blender Python,并且能用 Poly Haven 这类素材库。关键是让 Agent 自己检查自己的活,而不是闭着眼睛猜。具体有哪些工具,以它的 README 为准。
场景分三遍搭,每遍停一下
你要为一条竖屏 2.5D 短片搭"场景 2:大殿",通过 Blender MCP。

第一遍,搭体块:用灰色几何体搭墙、王座、柱子和地面。
按 shotlist.md 放好每一个相机,逐个相机取一张图,拼成一张图给我看。

第二遍,打光:一盏有来源的主光(窗户),加暖色实景光(烛火、火把),
再用一张 Poly Haven 的 HDRI 补光。不要用三点布光。从 3 个相机各出一张静帧。

第三遍,装饰:加上有磨损和变化的材质,旗帜、地毯和小道具。
每个相机都开景深,对焦在角色要站的位置。

渲染尺寸 1080×1920,不要渲染更大再裁。
主角道具永远是 3D
故事真正讲的那个东西,不要画成平面的。把它单独当成一个任务来做,先出一张多角度的检查图,再放进场景:
为这一集做主角道具:[物件,附参考图或描述]。
按真实尺寸,所有边都倒角,缝隙里要有磨损的材质。
先在中性的地面上渲一张 6 个角度的检查图给我看,
没问题后再放进场景 2 的标记点上。
第五部分:把 2D 角色放进 3D
2.5D 的核心就是:角色是平面图片,立在 3D 场景里。
- 在 Blender 里用"图像作为平面"导入,材质选发光或无阴影,这样场景的灯不会给角色上阴影。
- 脚下加一块柔和的接触阴影,角色才像站在地上,而不是飘着。
- 脸部用替换动画:一套眼睛和嘴,按每个节拍换。
先让 Agent 用 SVG 画出角色的零件:
把一个卡通角色画成一组 SVG 零件,背景透明:
头(一个圆)、身体、手臂、腿、符合 [角色身份、时代] 的帽子或服装。

另做一张表情表,每个表情单独一个文件:
眼睛:平常、睁大、眯起、闭上、斜视
嘴:闭、小开、大开、撇嘴、咧嘴
附加:汗滴、脸红

风格规则:纯色、同一种粗描边、不要渐变和纹理。
导出两倍大小的 PNG,再把所有零件作为平面导入 Blender,绑在同一套骨架上。
要有表演,不是弹跳
最容易看出"生成感"的地方是:角色从不思考。它只会弹跳、挥手、微笑,但动作之前脸上什么也没发生。动手之前,给每个镜头写一行"表演说明":
镜头 7(2.1 秒)"满朝都笑了"
想法:主人公知道自己是对的
预备:别的都还没动之前,先眯眼,提前 4 帧
动作:在"笑"这个字上转头看向镜头
停留:看着停 10 帧,让观众读懂

规则:不做待机弹跳。每一次动作都从一个眼神开始。只在重读的字上换嘴型。
第六部分:声音、字幕
用自己的声音,做逐词字幕
自己把脚本读一遍。真人的气口是这个形态里最大的信任信号,也让你不用考虑声音克隆的问题。
再让 Whisper 给每个词标时间,用这个文件做字幕层:
whisper voice.wav --model small --word_timestamps True --output_format json --output_dir captions/
读 captions/voice.json,在 Remotion 里做字幕层:
- 画面上一次只有 1 到 2 个词,按每个词的开始时间精确切换
- 粗体白字加深色描边,偏下居中,放在竖屏安全区内
- 不是每个词都有弹出动画,只给重读的词加
然后把 shotlist.md 里每一次切镜,对到它所属的那个词上。
声音要落在点上
图片来自 earshot 仓库,是它发布短片的分镜画面。
很多 AI 短片关掉声音时看起来还行,打开声音就露馅:切镜没卡上节拍,最后一帧落下时音乐还没收。
earshot 是一个开源的 MCP,让 Agent 能"听"音频并做评审,也能生成声音,只用 CPU。可以把它当成评审时的耳朵:
用 earshot 听 out/mix.wav,并对照 shotlist.md 检查:
- 人声始终在最上层,音乐在它下面
- 只有发生物理动作的地方才有音效
- 同一种嗖声不超过两次
- 音乐在最后一帧收住
然后把音效提示和画面事件写在同一个帧号上:
灯落地      帧 636   轻金属碰撞
睁眼        帧 640   音乐暂停 20 帧
最后一句    帧 1900  音乐收住
一个小提醒:音效文件开头如果有一点前奏,听到的"撞击"会比文件起点晚。要在波形上找到峰值,再把片段偏移,让峰值落在目标帧上。
第七部分:评审循环
不要把完整成片看十遍,看"接触表":
# 每秒一帧,整集拼成一张图
ffmpeg -i out/episode.mp4 -vf "fps=1,scale=240:-1,tile=8x9" -frames:v 1 review/contact.png

# 手机测试:缩到 360 像素宽,每 3 秒一帧
ffmpeg -i out/episode.mp4 -vf "fps=1/3,scale=360:-1,tile=6x4" -frames:v 1 review/phone.png
修一处就不要重渲整集。Blender 可以从命令行只渲一帧或一个区间:
# 只渲一帧
blender -b episode.blend -o //review/still_ -f 636

# 只渲修改附近的区间
blender -b episode.blend -o //review/fix_ -s 600 -e 660 -a
再把接触表交给 Agent,让它当评委,而不是作者:
打开 review/contact.png 和 review/phone.png。
你没有做过这条片子,你是我认识的最苛刻的动画导演。

检查:每个角色脚下有没有接触阴影?有没有角色被打得像 3D 物体?
有没有哪个镜头超过 3 秒还没有新想法?字幕在手机尺寸上读得清吗?
画面上有没有 sources.md 里没有的结论?

列出所有问题并标时间点,修最严重的 3 个,只重渲这几秒,再给我新的接触表。
给每一条修改都写四个字段:在哪、哪里不对、改成什么、什么必须不动。有边界的修改,Agent 不会乱跑:
修改镜头 9,依据 shotlist.md。
位置:全局帧 630 到 640
问题:灯落地发生在帧 644,比碰撞声晚了 8 帧
修改:只改灯的下落,从 630 开始,636 落地,加速下落,不反弹
保持:镜头的慢推、帧 640 的切镜、字幕时间、其他所有镜头不动

输出 630、633、636、640 四帧静帧和 600 到 660 的预览,检查中间帧有没有跳变,
报告改了什么和输出文件。
修改顺序:先修错的和缺的,再修可读性,再修节奏,最后才是画面细节。
通过之后,上传前检查一下导出:
ffprobe -v error -select_streams v:0 -show_entries stream=width,height,avg_frame_rate,duration -of json out/episode.mp4
应该看到 1080×1920、30/1 的帧率,以及你计划的时长。
第八部分:打包成自己的 Skill
流程跑通之后,把它存成一个 Skill,下一集只要一句话:
---
name: cartoon-studio
description: 制作竖屏 2.5D 动画短片(扁平 2D 角色放在 Blender 打光的 3D 场景里),讲一个真实故事。当用户要做历史或科学短片、动画科普或故事类短片时使用。
---

# 2.5D 短片

## 流程
1. 给出 5 个带出处的真实故事,等我选。
2. 写 script.md(150 到 170 字)和 sources.md,等我确认。
3. 写 shotlist.md:一个想法一个镜头,复用 3 到 5 个场景。
4. 在 Blender 里分三遍搭场景:体块、打光、装饰,每遍出检查图。
5. 主角道具用 3D 做;角色用 SVG 零件变平面,纯色材质,加接触阴影。
6. 每个镜头先写表演说明,再做动画。
7. 我的声音 → 逐词时间戳 → 字幕 → 混音,用 earshot 检查。
8. 接触表加手机测试 → 评委检查 → 修最严重的 3 个 → 重复。

## 硬性规则
- 1080×1920,按尺寸渲染。只用真实的事实,每一条都要在 sources.md 里有出处。
- 不复制别的频道的角色、设计或脚本。
保存到 ~/.claude/skills/cartoon-studio/SKILL.md,用时直接说"用 cartoon-studio 做一集"。
第九部分:第一集怎么做
- 只做一集,别先规划频道。做完再决定。
- 选一个你本来就想讲给朋友听的故事。 如果它不能让你说出"真的假的?",也就不会让陌生人停下滑动。
- 给整个过程计时。 记下故事、场景、角色、动画、配音、声音和评审各花了多久,第二集会告诉你第一集真正的成本。
- 文档和视频放在一起。 script.md、sources.md、shotlist.md、声音提示表和最终导出都放在同一个文件夹里,这个文件夹就是第二集的模板。
- 像观众一样看。 正常速度,手机上,开声音。再闭上眼睛听一遍。
- 看留存曲线,不是看播放量。 发布后看平台的观众留存图,那里能看到大家具体在第几秒离开。
合规和平台
这一部分决定频道能不能活得久。
- 学语法,不抄内容。 研究一个频道怎么构图、剪辑和做字幕,但绝不复制它的角色、设计或脚本。
- 做原创的每一集。 平台的变现政策针对批量生产的重复内容。每一集用真实故事、自己的声音和新场景,才不会落入那一类。具体以平台官方最新政策为准。
- 留意 AI 披露。 平台对"可能被当成真实"的内容有披露要求;明显不写实的动画一般不在此列,但如果有任何内容可能被误认成真实影像,就标出来。同样以官方为准。
- 事实必须是事实。 sources.md 不是形式主义。评论区里一个错误的日期,比任何渲染都更伤信任。
仓库清单
- mcp-for-blender:让 Agent 控制 Blender。
- blender-claymation-skill:Blender 黏土动画的 Skill,适合拿来学一个 Blender 技能是怎么写的。
- motion-design-skill:动效原则。
- gsap-skills:GSAP 官方技能。
- remotion skills:用 Remotion 合成视频。
- hyperframes:用 HTML 做视频的框架。
- earshot:给 Agent 用的声音工具。
- whisper:逐词时间戳。
评论(0)
还没有评论,来说第一句。